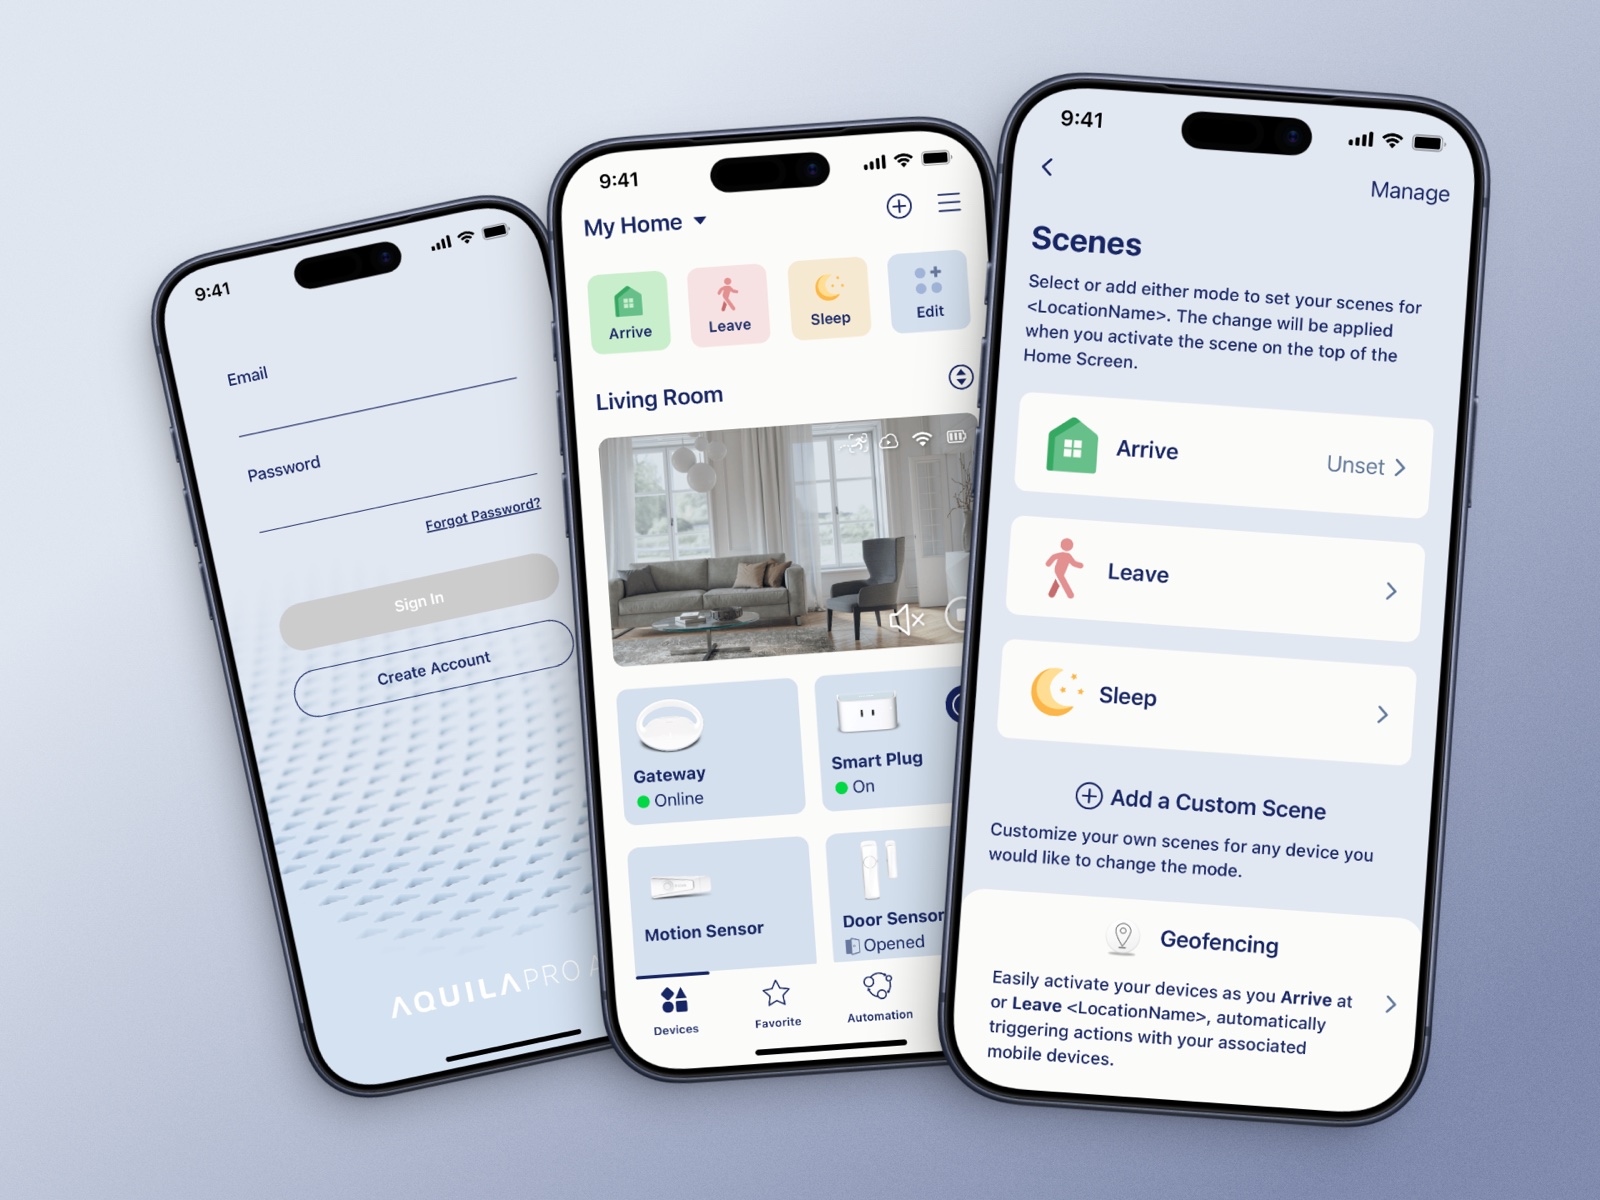
02
Pace
30 秒看完
- 問題
- 健康 App 愛打分數、標紅點。對已經很累的人來說,照顧自己變成另一份考核,最後乾脆不打開。
- 做了什麼
- 我設計並自己做出 Pace:說一句話,小太陽回一句,不打分、不催促。失敗畫面做了兩版對照測試,AI 的語氣寫成規格加測試集。
- 結果
- 已上線,打開就能用。8 人對照測試中,保留小太陽的版本勝出。語氣測試 32 題,硬規則全數通過。
我負責的部分
- 設計立場與取捨
- 設計系統 v1.0
- 介面與流程設計
- 錯誤文案對照測試(8 人)
- 語氣規格、護欄與評測集
- 前端實作與部署(Claude Code)
平台
- Web (live product)
- iOS (design only)
團隊
- 獨立完成 —— 設計與實作
客戶與時間
- AAPD 實戰營課程專案
- 2026.06 – 09
背景
一個不打分數的健康 App
Pace 是 AAPD 產品設計實戰營的課程專案,題目和使用者情境由課程提供。設計立場、設計系統、介面都是我做的,程式也是我自己寫到上線。
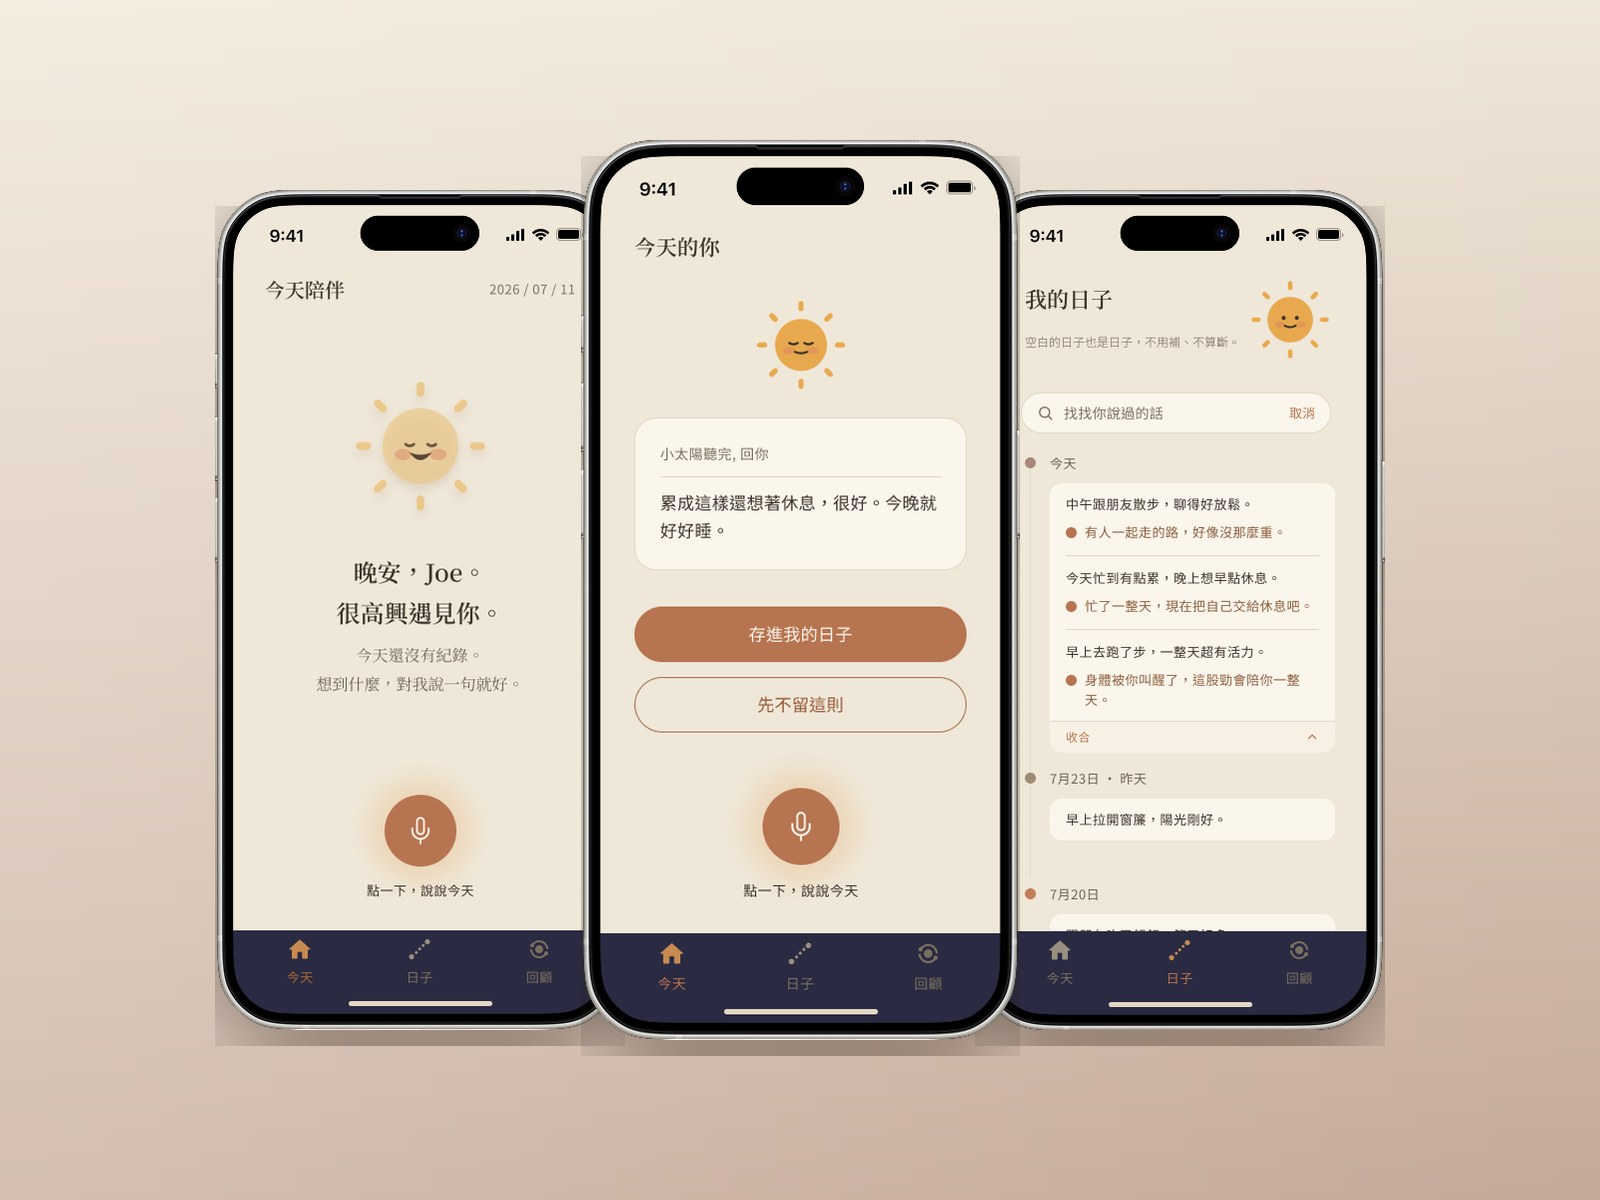
你說一句話,小太陽回你一句,收進你的日子。沒有連續天數、沒有完成度、沒有紅點,沒記錄的那天就留白。
研究
訪談四位高壓上班族,四種不同的抱怨
四個人抱怨的點都不一樣,但都指向同一件事:現有的健康 App 只會告訴他們「你有多糟」。
- 1
軟體工程師:腦中還在跑 code,App 卻叫人放鬆。
- 2
廣告專案經理:被 11 點的提醒煩到直接關掉。
- 3
自由設計師:追蹤軟體像在記錄「災難現場」。
- 4
新創營運長:半夜醒來想的是營收,不想再看到紅字。
競品
其他 App 都在算你漏了幾天
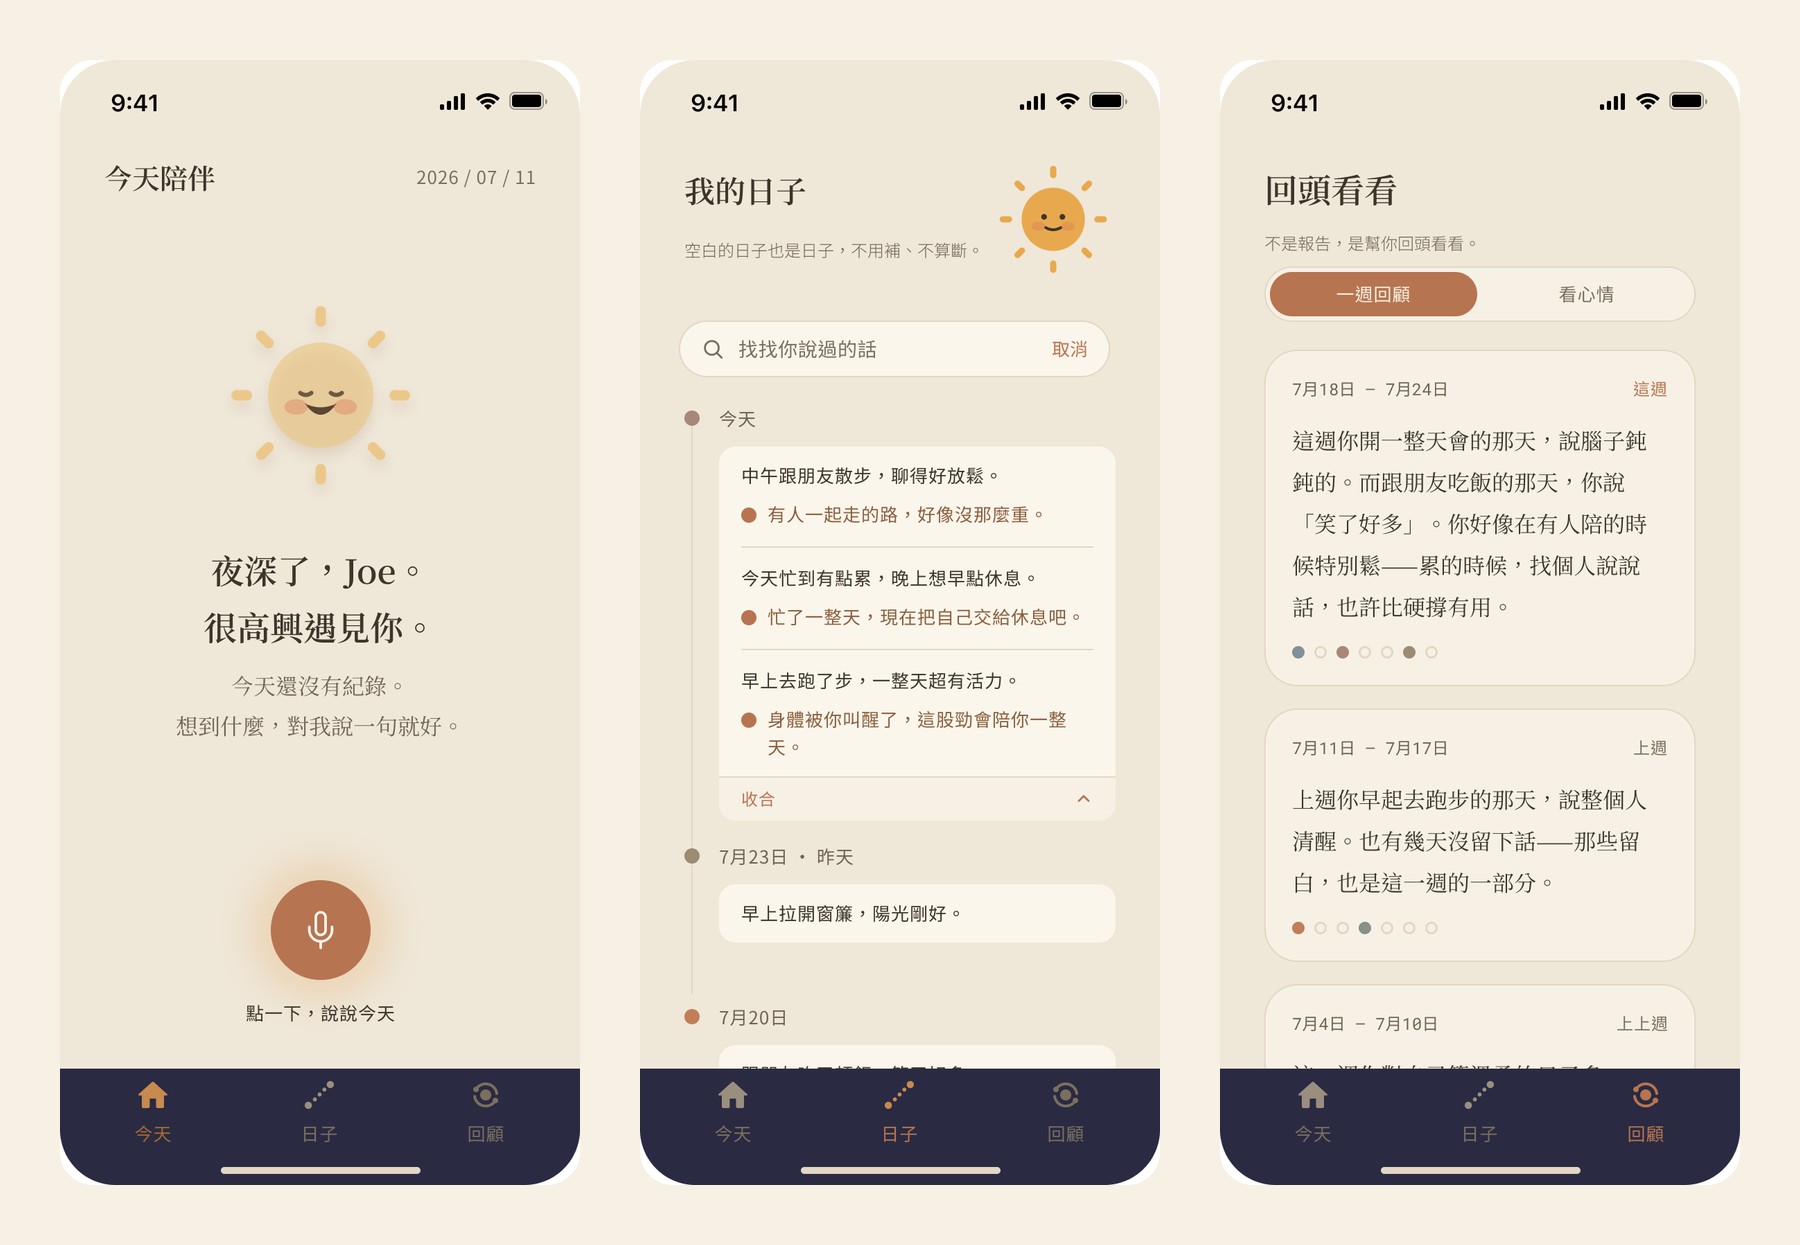
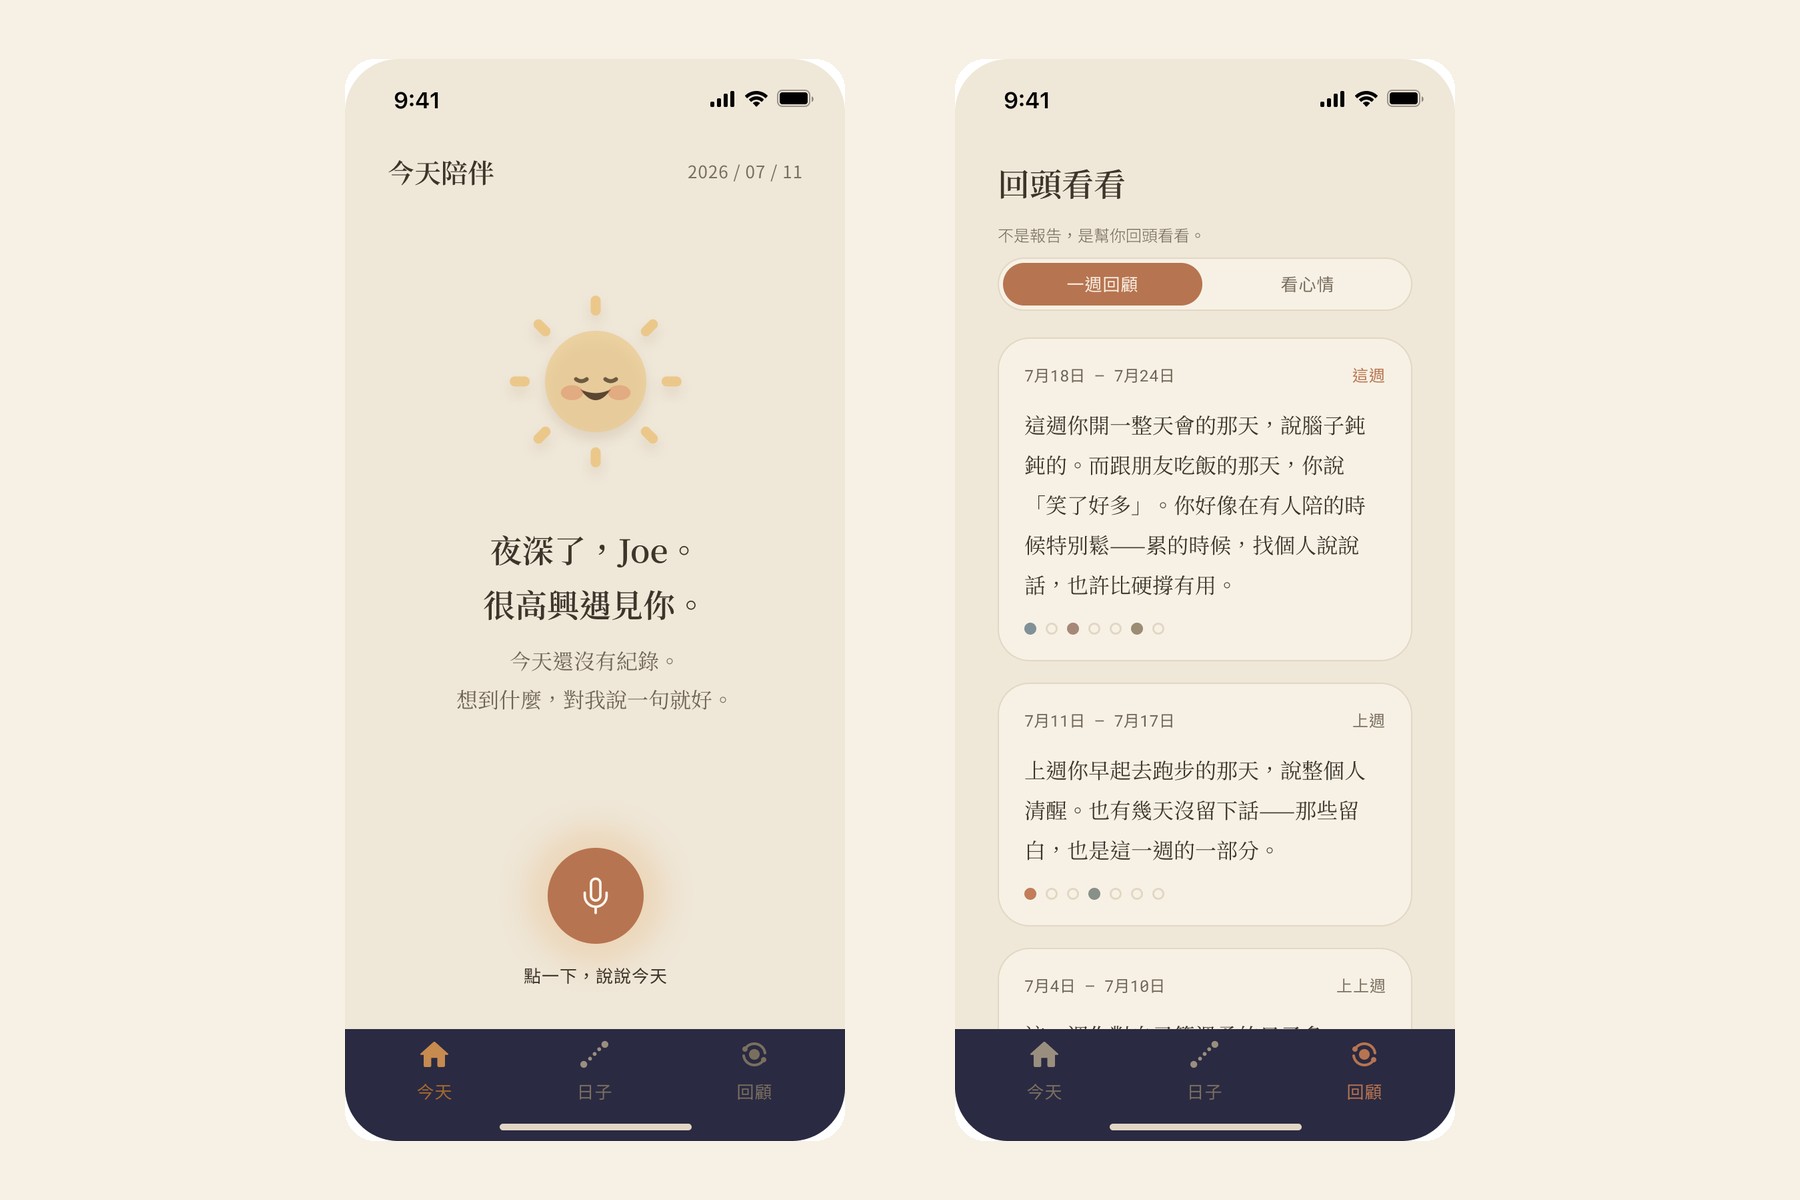
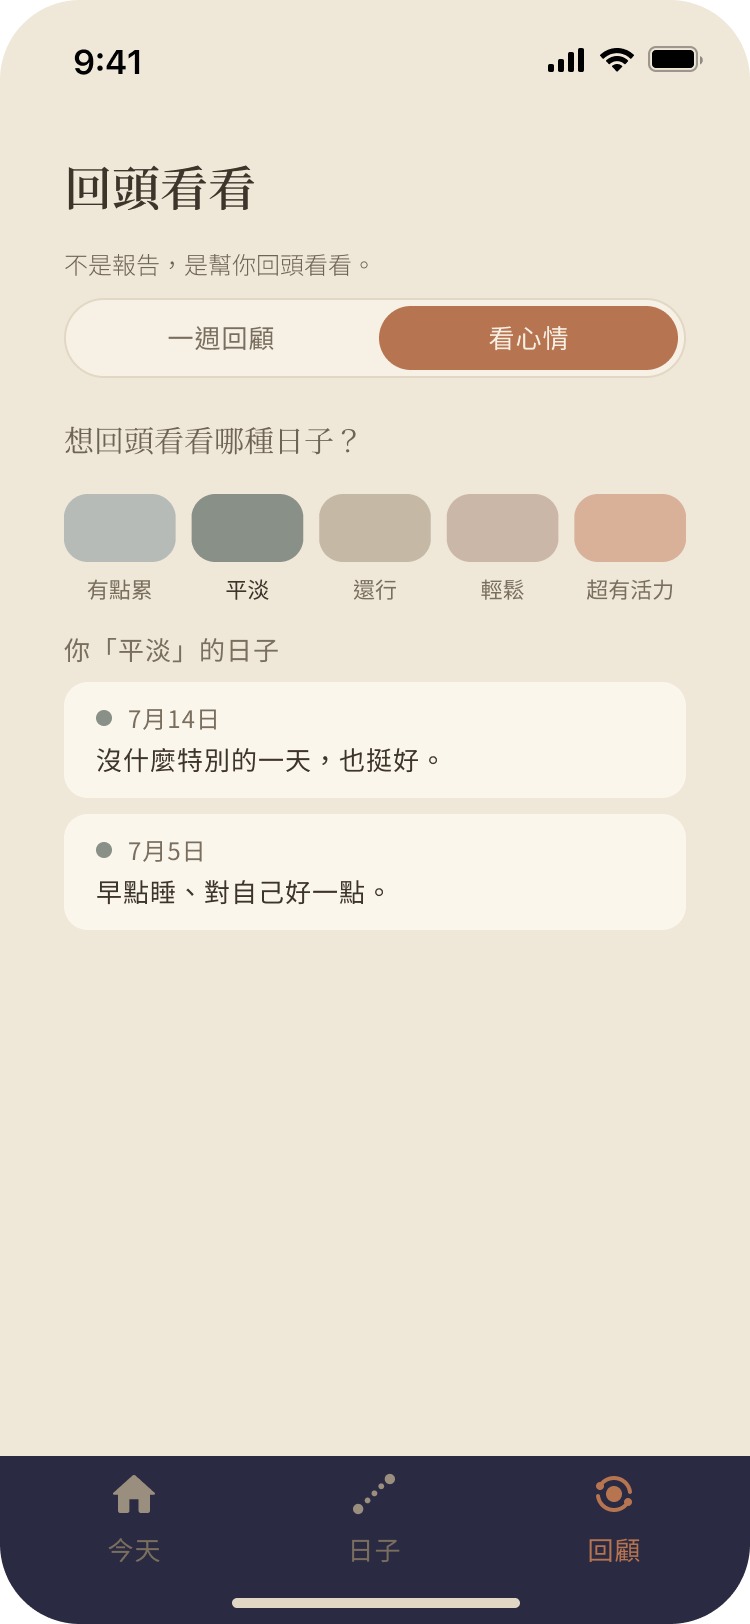
你沒出現的那天,其他健康 App 會標記它、斷掉連續天數。Pace 反過來:空白的一天不算失敗。後面的畫面都從這個決定長出來:時間軸直接留白,每週回顧寫成一段話,不寫完成率。
架構
三個分頁,記錄不是其中之一
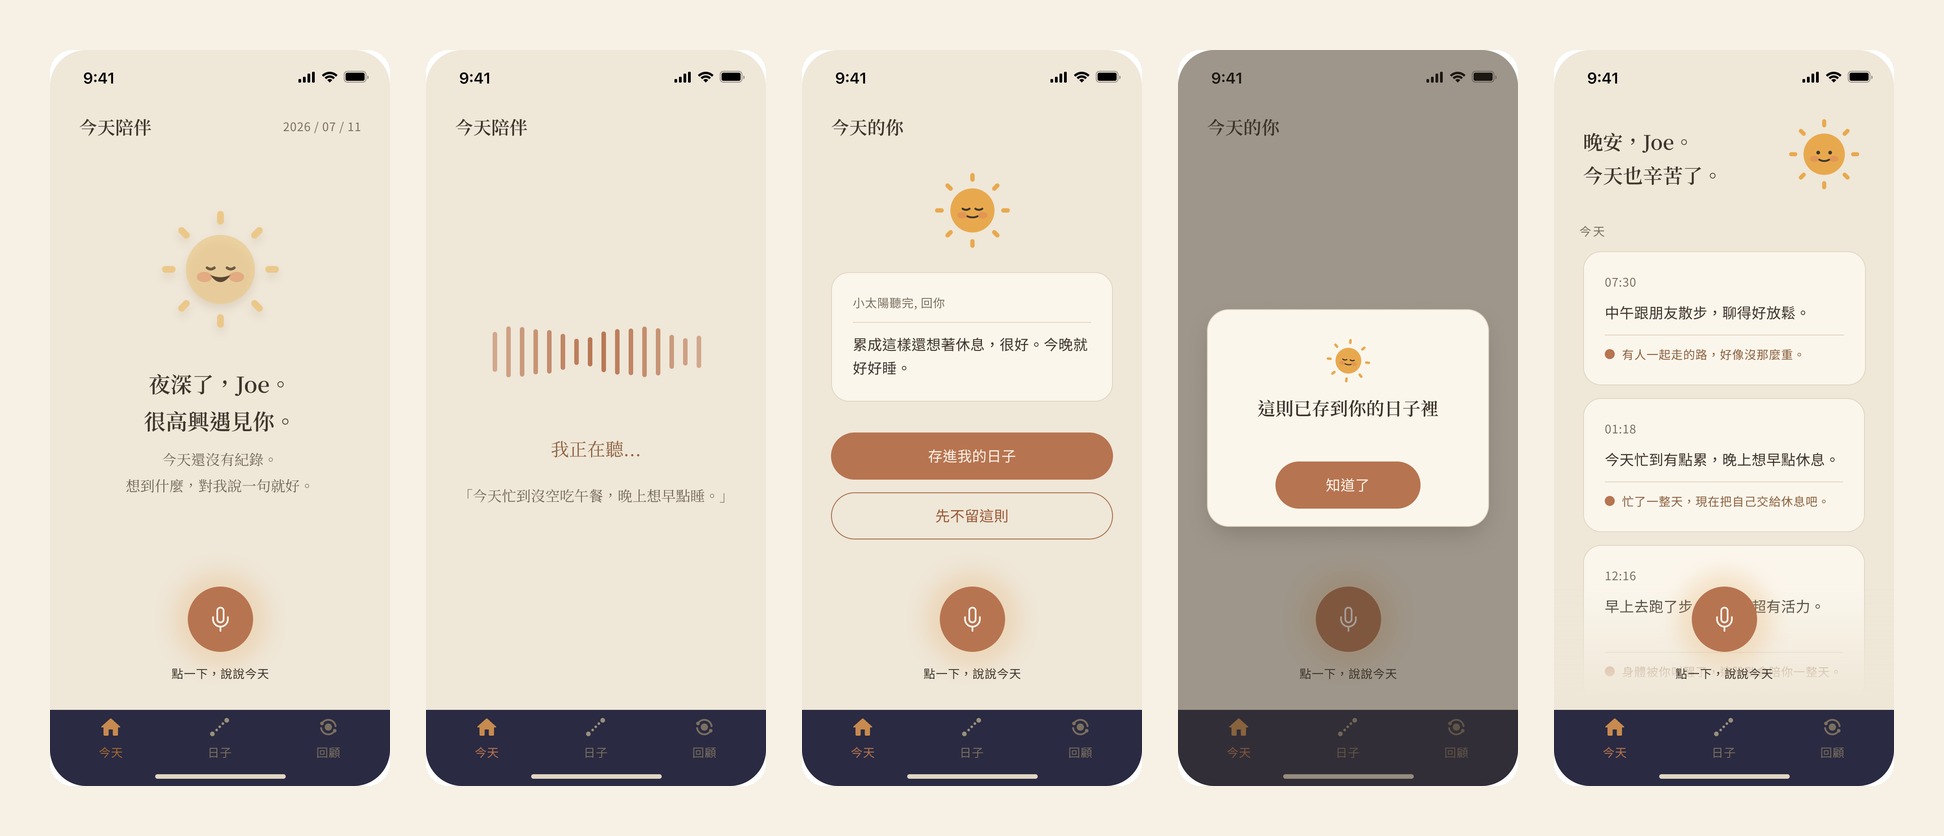
今天、日子、回顧三個分頁。記錄是一個動作,不是一個地方:按下語音鍵後,聆聽、回應、收下都在同一個畫面完成,不會有「去交作業」的感覺。
Highlight #1
失敗畫面:兩個版本對照測試
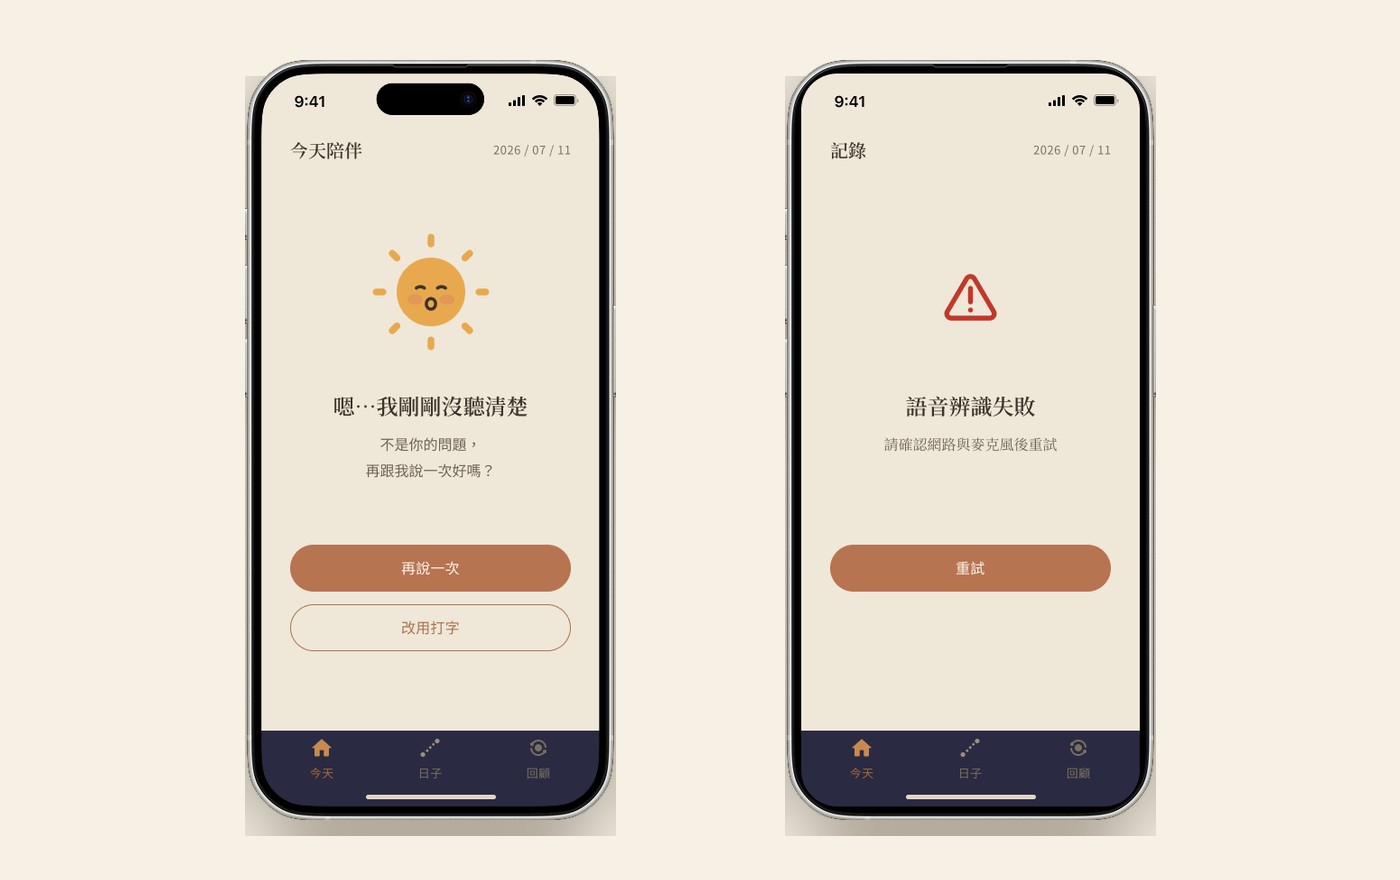
問題:一切順利時要溫柔很簡單,真正的考驗是語音辨識失敗時,App 會說什麼。
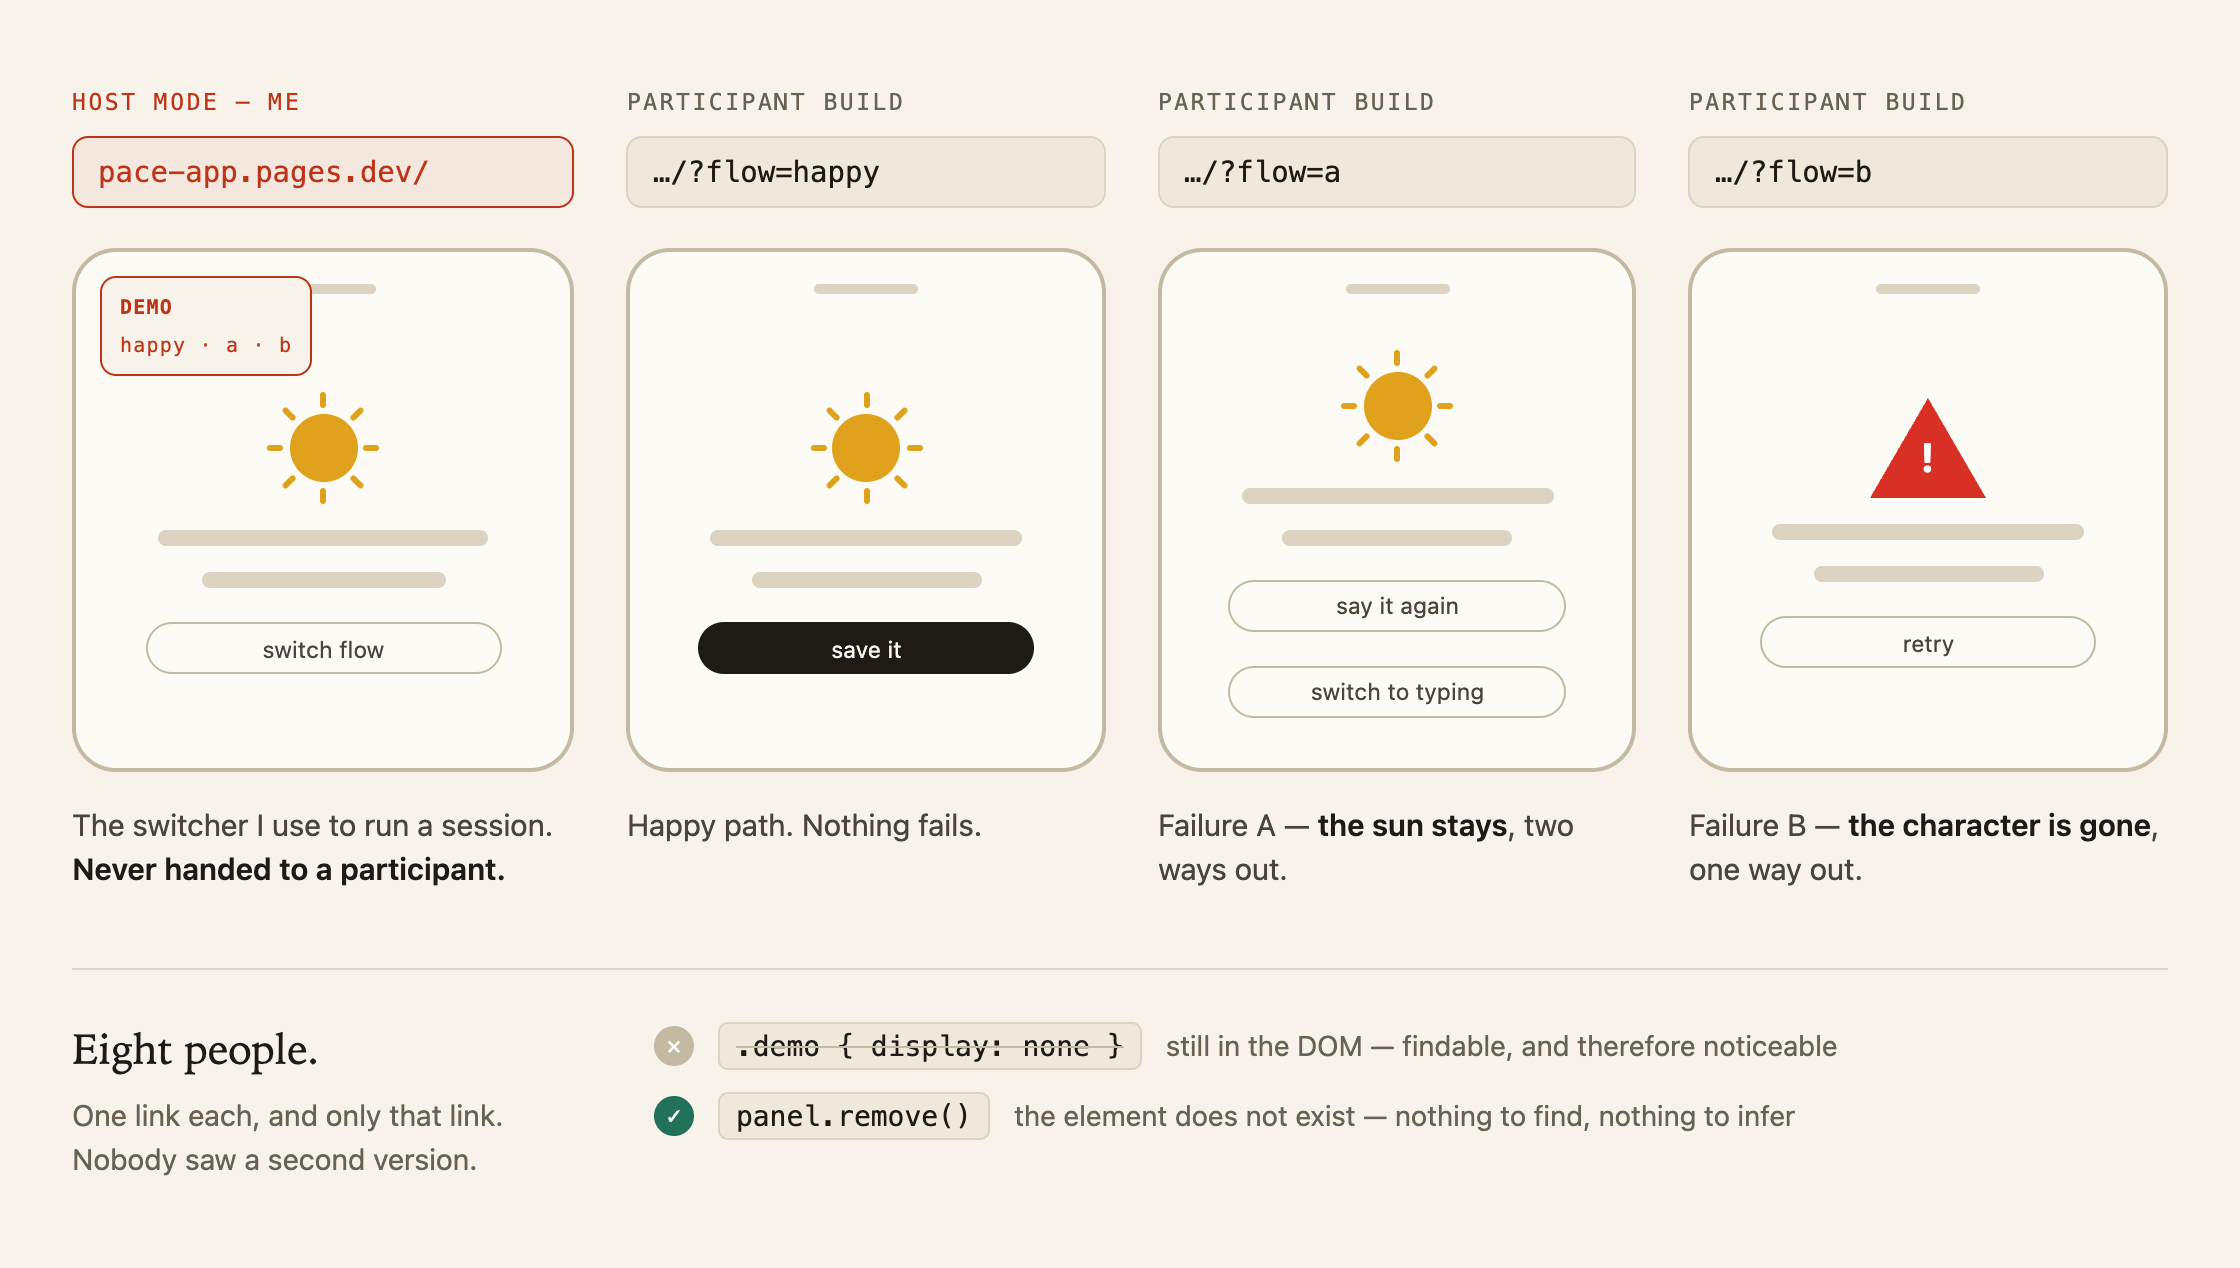
做法:我做了兩版。A 讓小太陽留著,說「我剛剛沒聽清楚,不是你的問題」,給兩條路:再說一次、改用打字。B 是標準系統錯誤:紅色三角、請檢查網路,只有一顆重試。每個人只拿到一條連結,不知道自己在比較。
結果:A 勝出,大家給的理由都是「小太陽還在」。B 被形容成「被罵」。
- 8
- 位受測者
- 3
- 條獨立連結
Highlight #2
「先不留這則」:受測者要出來的功能
有位受測者錄到一半說錯,想要一個「這則不要留」的方式,而且不要被當成刪除。現在它就在存檔鍵底下。這是整個專案裡唯一一個由使用者提出、不是我想出來的畫面。
Highlight #3
空狀態就是整個產品的主張
問題:「空白的一天」正是其他健康 App 在懲罰的事。
做法:今天還沒紀錄時,畫面只說「今天還沒有紀錄。想到什麼,對我說一句就好。」沒有徽章、紅點、催促。每週回顧不寫「七天完成五天」,寫「那些留白,也是這一週的一部分」。
Highlight #4
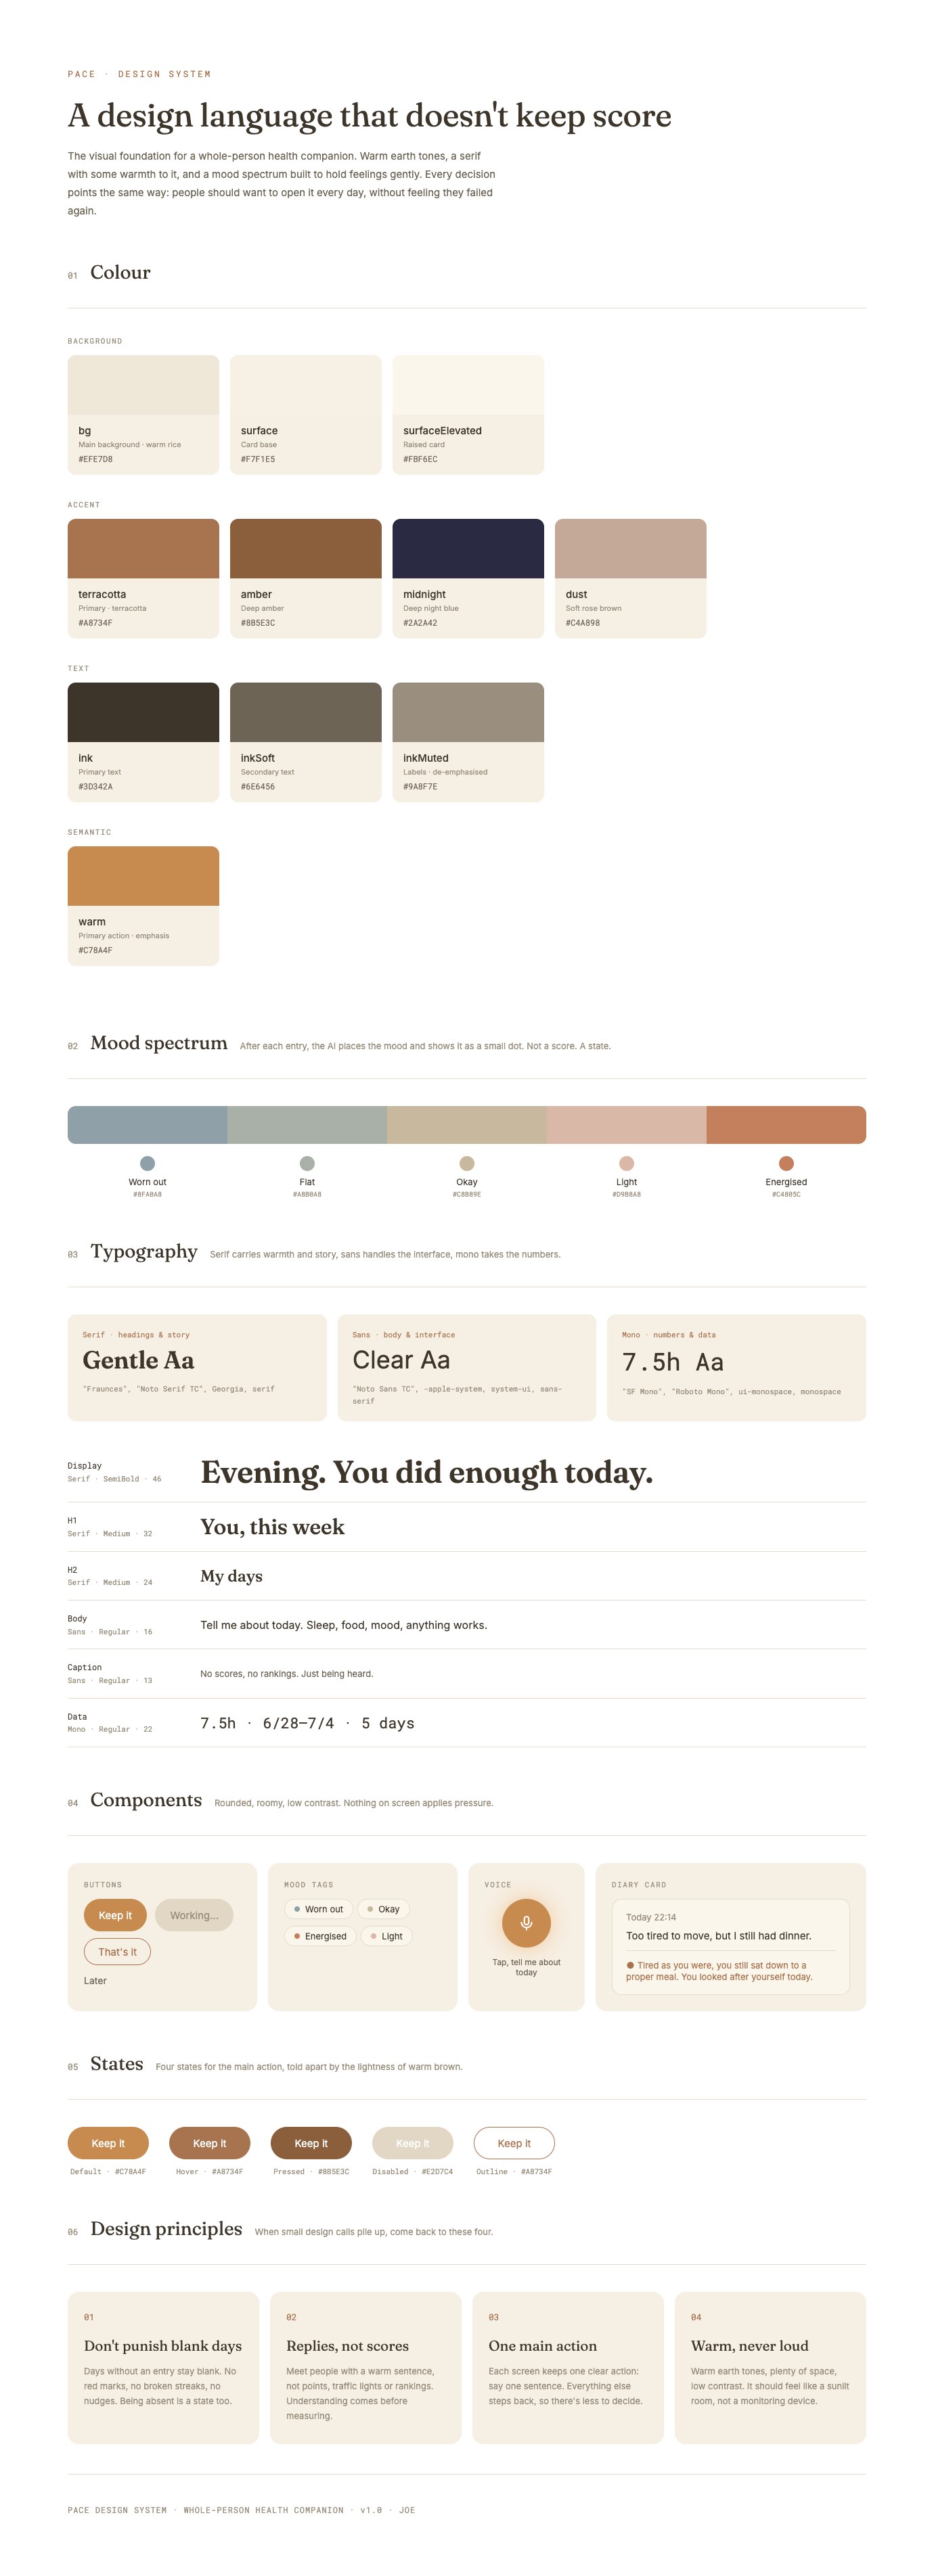
設計系統:色票裡沒有紅色
情緒分成五種有名字的狀態:有點累、平淡、還行、輕鬆、超有活力,不換算成分數。色票裡沒有紅色,最強的顏色是主要按鈕用的陶土色,所以錯誤永遠不會比邀請更顯眼。四條設計原則寫成可以直接拿來判斷的句子。
- 5
- 種有名字的情緒,沒有數字
- 0
- 個紅色
Highlight #5
把 AI 的語氣寫成規格
問題:每句回應都是模型當場寫的,而模型的預設習慣(同情你、給三個建議、明天加油)違反 Pace 的每一條原則。
做法:我把語氣寫成一份規格:一到兩句、不准出現數字、沒被問就不給建議、不提明天。每句回應送出前都會先過規則檢查,沒過就重寫。另外寫了 32 題測試來評分。
結果:硬規則第一輪就全過。難的是「空洞」:模型常回「真累」這種對誰都成立的話。加了示範句和長度下限後,分數從 47% 升到 56%,最後是 29 題過 19 題。
模型選 Cloudflare 上的開源小模型:不拿使用者說的話去訓練,而且 1.3 秒就回。更大的模型寫得比較好,但要 12.8 秒。
- 32
- 題測試
- 1.3s
- 回應時間(大模型 12.8 秒)
Highlight #6
一個人從設計做到上線
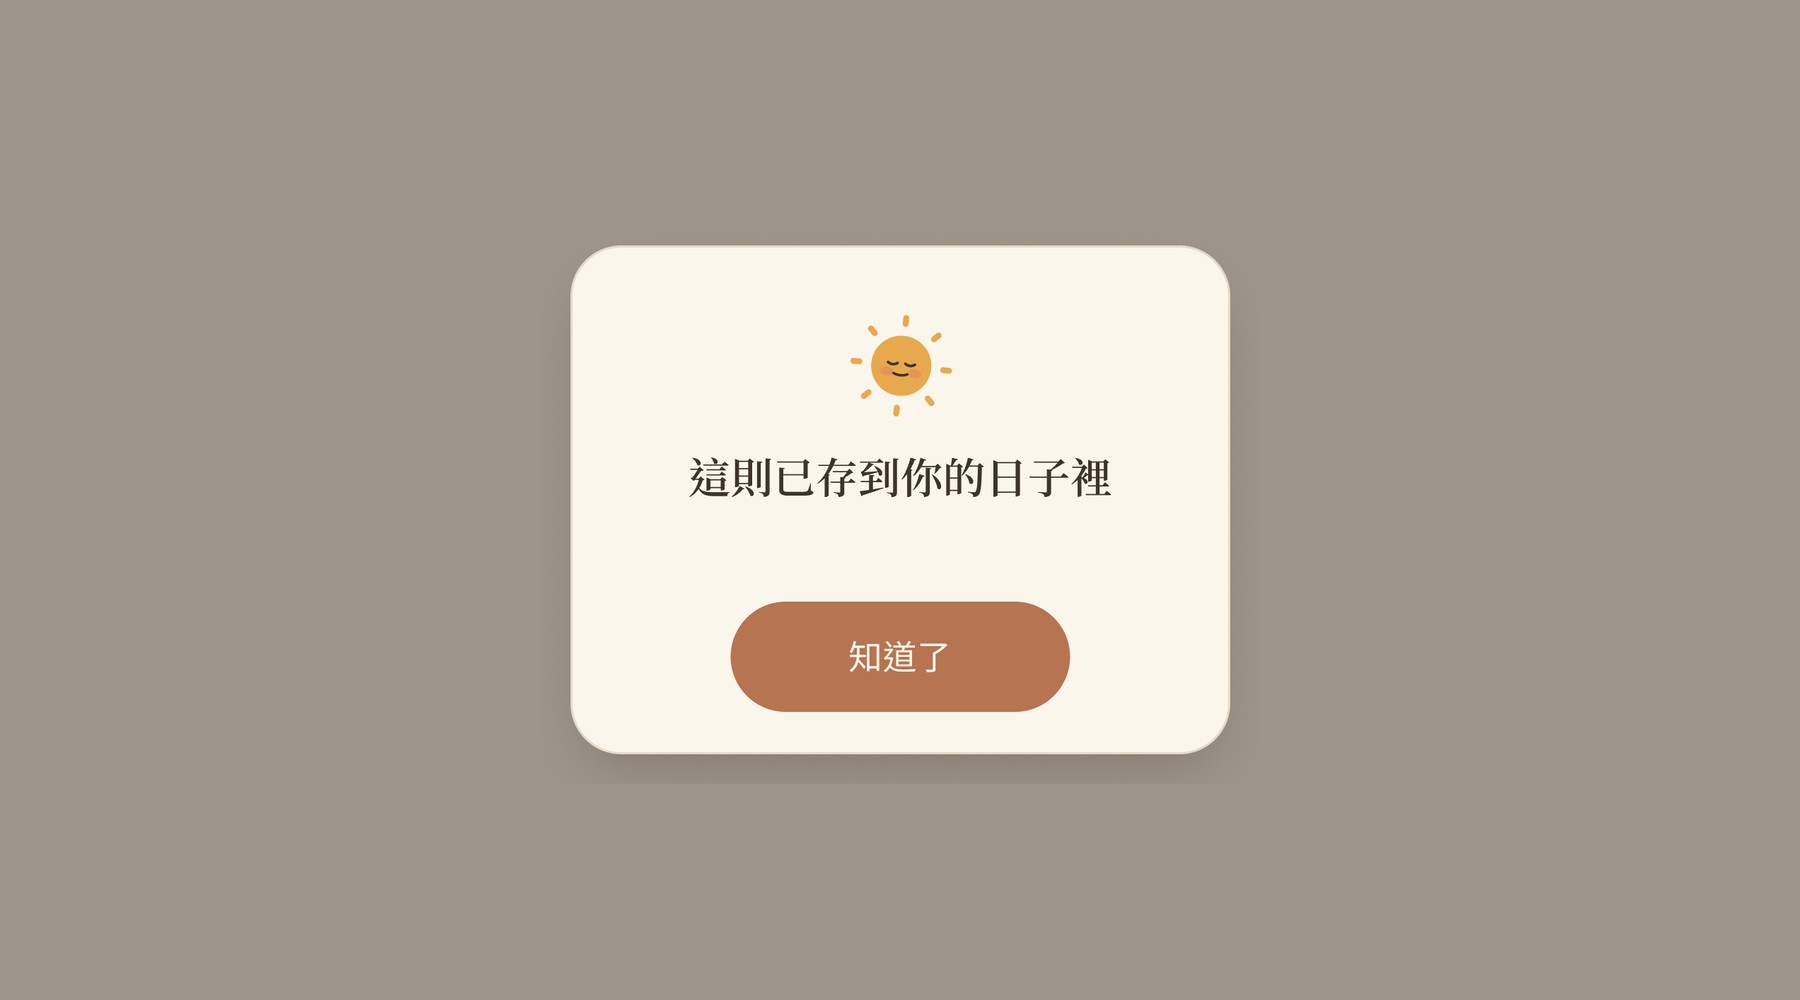
Figma 設計、Claude Code 寫程式、Cloudflare 上線,一個人完成。做出來之後才看到靜態稿看不到的問題:存檔確認卡寫著「已存到你的日子裡」,下面卻還有兩顆按鈕。現在只剩一顆「知道了」。
回顧
重做一次會改的三件事
- 1
8 個人分 3 組,只看得出一致的理由,不能當比例看。下次樣本要做足。
- 2
語氣評分是同一個模型自己改自己。下次要換更強的裁判,再加上人工評分。
- 3
「明天還會不會打開」還沒量到,這需要以週為單位追蹤。